技術筆記
讓機器自己寫故事:在本地跑一個語言模型
從語言模型的基本原理講起,說明為什麼要在自己的機器上跑 LLM、一個本地服務長什麼樣,最後用 Docker 把 Ollama 架起來並發出第一次生成請求。
做一套 AI 繪本生成系統,第一步永遠是文字:先有故事,才有畫面與聲音。這篇不談怎麼串接某個雲端 API,而是回到最根本的問題——怎麼在自己的機器上,跑一個會寫故事的語言模型。看懂這件事,之後不管要換本地模型還是雲端服務,心裡都有底。
技術前導:語言模型到底在做什麼
很多人以為語言模型「理解」了故事,其實它做的事單純得多:看著前面的文字,猜下一個字最可能是什麼,猜完接上去,再猜下一個,一路接成一整段。
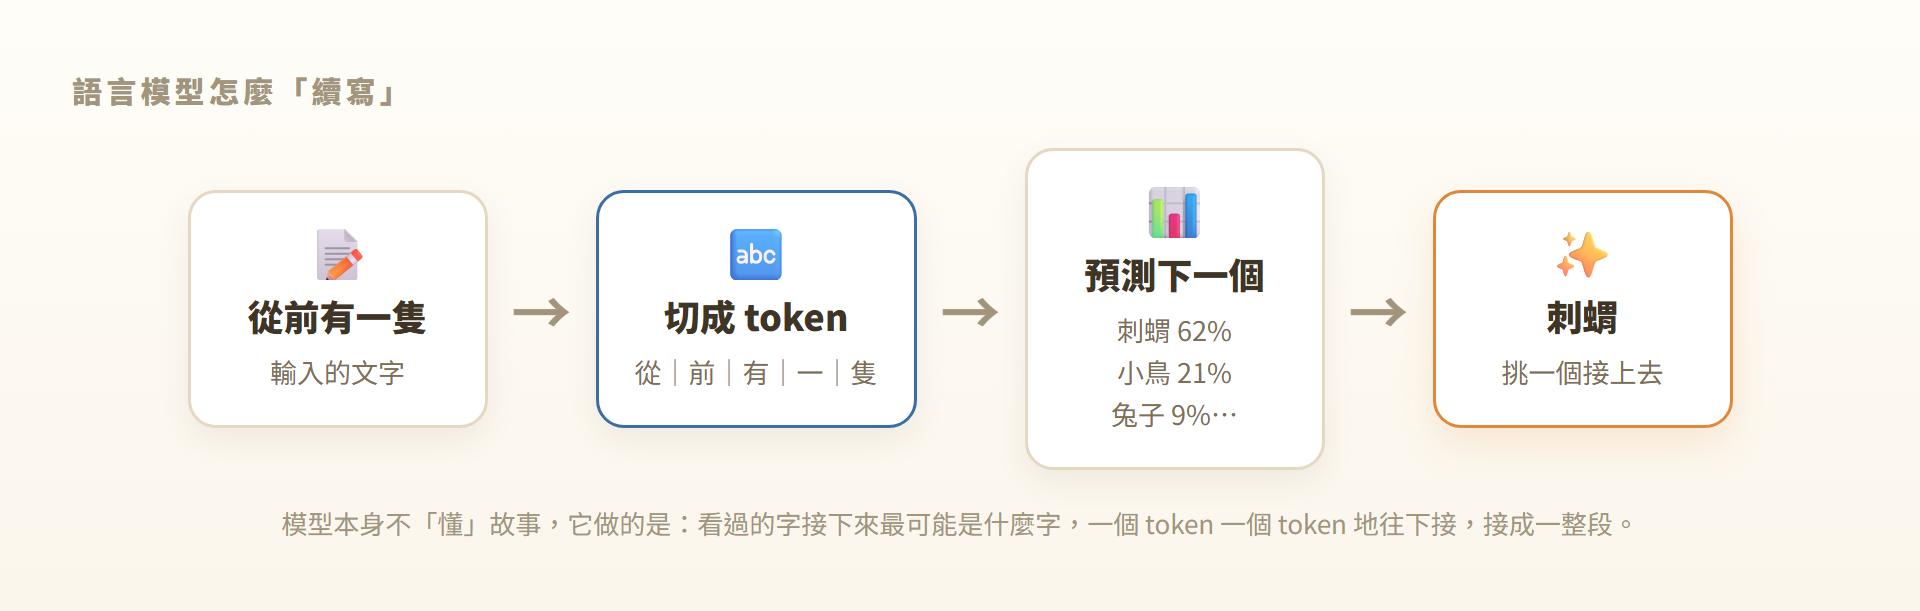
這裡有兩個要記住的詞。Token 是模型處理文字的最小單位,中文大約一到兩個字一個 token。續寫則是它唯一會做的事:所有的問答、翻譯、寫故事,本質上都是「給定前文,把後面補完」。理解這一點,你就會明白為什麼「提示詞(prompt)怎麼寫」這麼關鍵——你不是在下命令,而是在給模型一個好的開頭,讓它往你要的方向接下去。
為什麼要在本地跑
同樣是用 LLM,把它跑在自己機器上和接雲端 API 是兩種思路:
- 資料不出門:故事草稿、角色設定都留在自己機器,不經過第三方。
- 成本固定:電費之外沒有按量計費,適合大量、反覆地生成。
- 可離線、可控:模型版本自己鎖定,不會某天被服務商悄悄換掉。
代價也很實在:你需要一張夠力的顯示卡,而且模型品質和它的大小高度相關——能跑在一張消費級顯卡上的模型,寫作能力通常比不上頂級的雲端模型。實務上很多系統是混搭的:本地模型做量大、不敏感的前處理,關鍵環節再交給更強的服務。但無論如何,先學會在本地把一個模型跑起來,是理解整件事的基礎。
統概:一個本地 LLM 服務長什麼樣
你不會直接「執行」一個模型檔,而是讓一個常駐服務把模型載入記憶體,之後透過 HTTP 反覆呼叫它。最省事的選擇是 Ollama:它把「下載模型、載入、對外開一個 API」這幾件事都包好了。
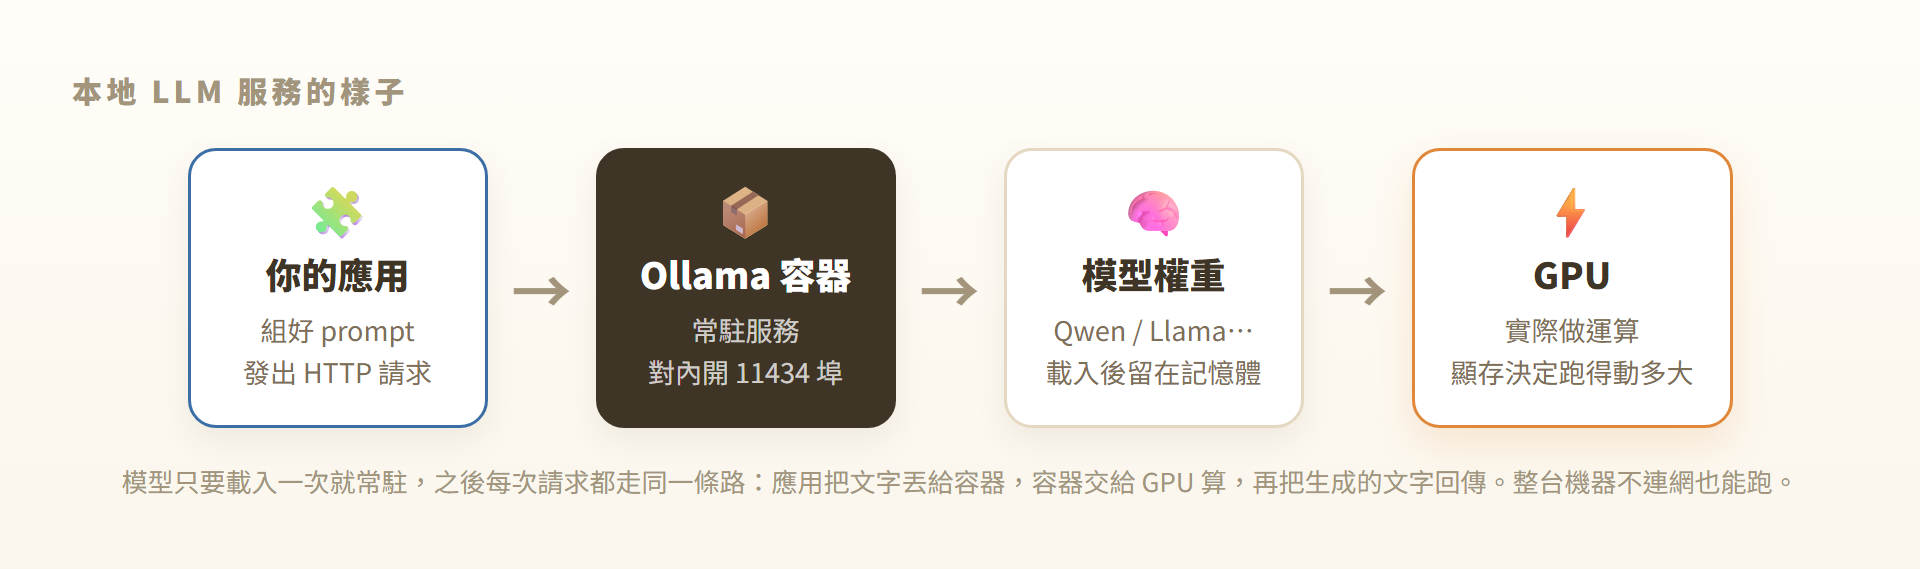
重點在「常駐」:模型檔動輒好幾 GB,載入一次要花時間,所以服務會把它留在記憶體,之後每次請求都省下載入成本。真正吃資源的是 GPU 的顯存——它決定你跑得動多大的模型。
帶入模型:挑一個跑得動的
模型名稱後面常帶一個數字,例如 7b、14b,指的是參數量(70 億、140 億)。參數越多通常越聰明,但也越吃顯存。一個粗略的對照:7B 等級的模型量化後大約需要 5~6 GB 顯存,一張 8 GB 的卡剛好跑得動。
對中文繪本來說,除了大小,還要看中文能力。像 Qwen 這類對中文友善的模型,在繁體中文的用詞和語氣上會比純英文訓練的模型自然許多。挑模型時,先確定顯存跑得動,再從跑得動的裡面挑中文表現好的。
容器化與第一次呼叫
把服務放進 Docker,好處是環境一致、GPU 設定寫在設定檔裡、換機器也能重現。關鍵是兩件事:用 volume 把模型快取存起來(不然每次重建容器都要重抓),以及把 GPU 掛進容器。
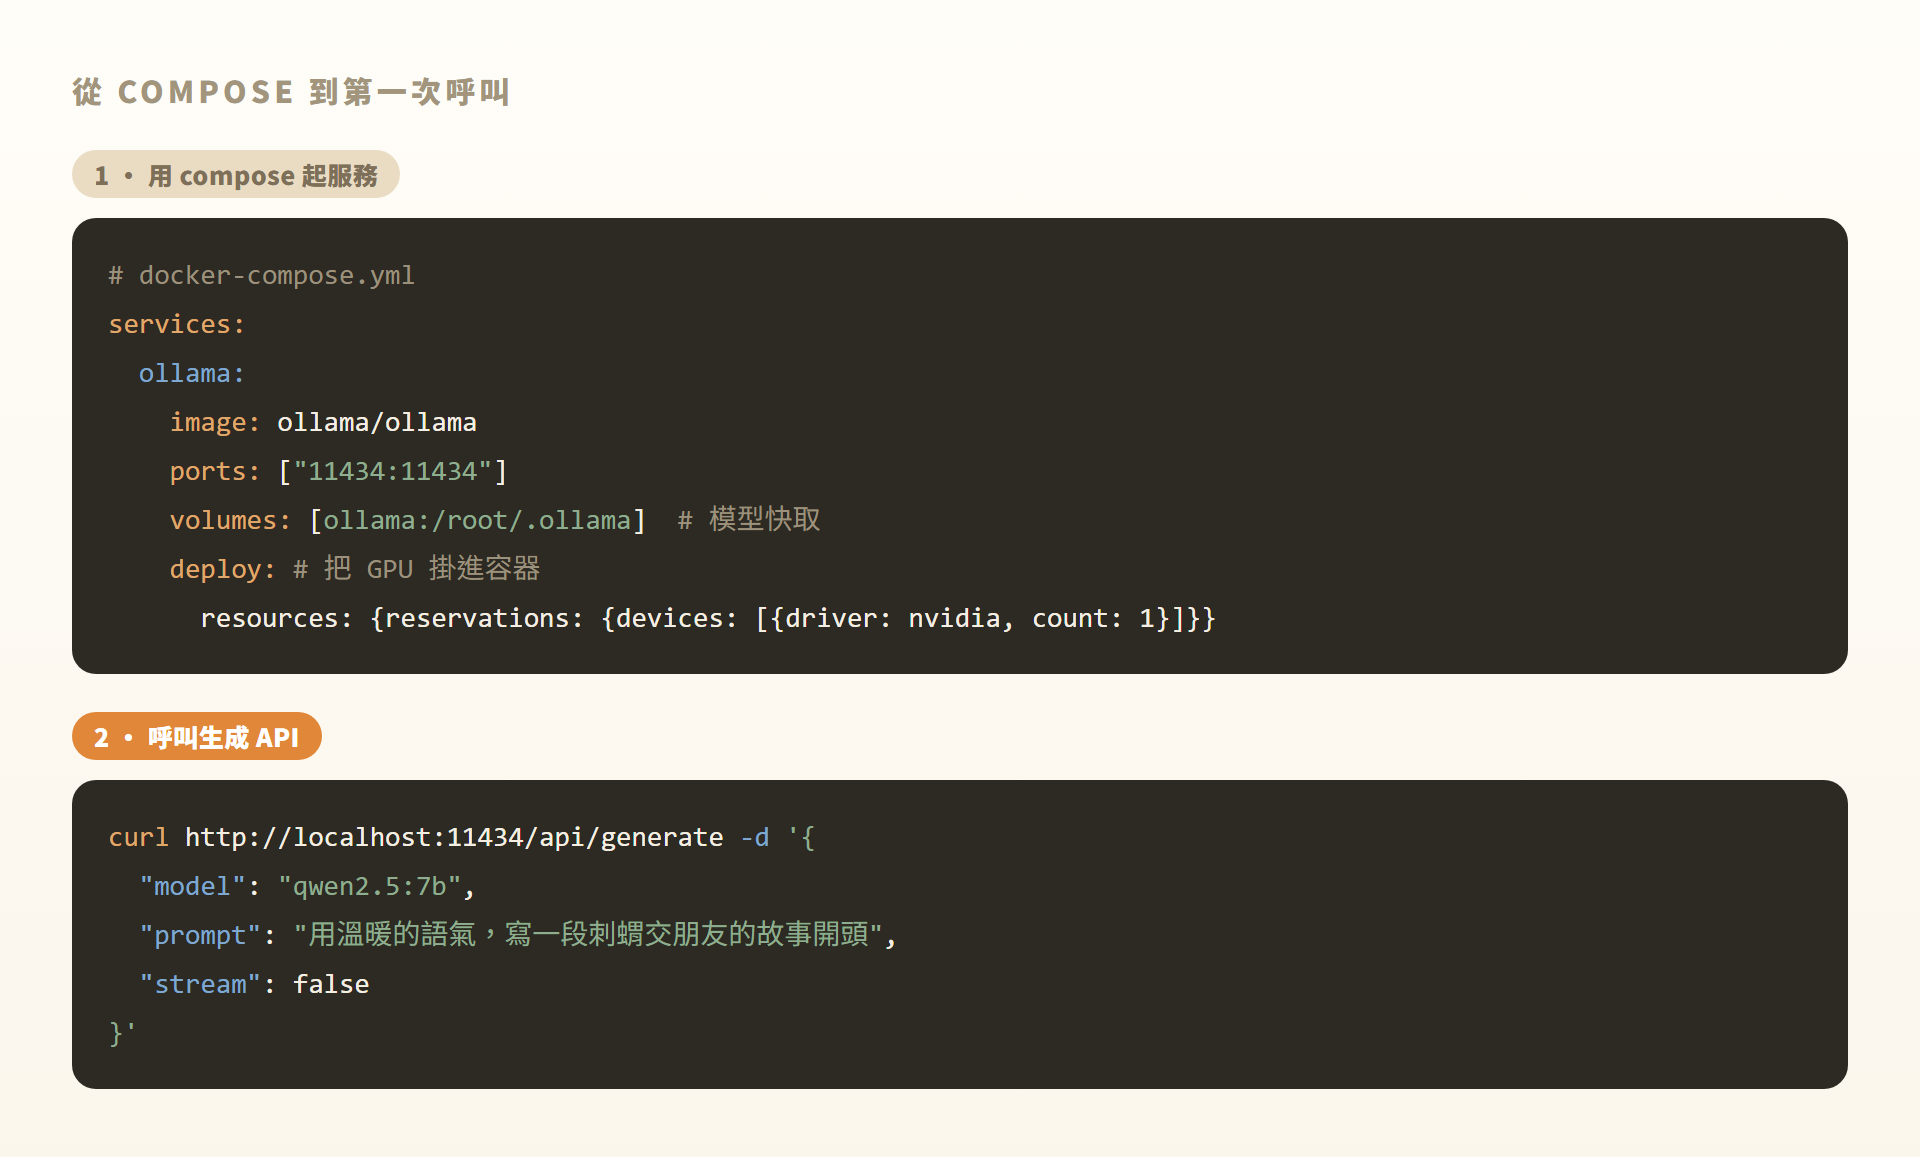
服務起來、模型也拉好之後,發一個請求就能拿到生成結果。/api/generate 收下你的 model 與 prompt,回傳續寫出來的文字。第一次看到自己機器上的模型吐出一段故事,那個「原來可以在本地跑起來」的踏實感,是接雲端 API 換不到的。
從「能跑」到「能用」
能生成,不代表好用。要讓它穩定產出可用的故事,還有幾個旋鈕要調:
- 提示詞:與其說「寫一個故事」,不如給角色、場景、語氣、長度的具體框架。前文給得越清楚,模型接得越準。
- temperature:控制隨機性。低一點輸出穩定但單調,高一點有創意但容易發散;寫故事通常取中間偏低。
- 接進流程:模型輸出是純文字,後面還要程式去切句、分頁,才能餵給畫圖與配音。這條線怎麼接,就是整套系統的骨架。
先在本地把一個模型跑起來、發出第一次請求,你對「AI 怎麼寫故事」就從模糊的想像,變成手上摸得到的東西。接下來的圖、聲音、影片,都是從這段文字長出來的。