技術筆記
一句話變一張插畫:在本地跑文生圖
從擴散模型的原理談起,說明一張 AI 插畫是由底模、LoRA、VAE 疊出來的,為什麼用 ComfyUI,最後用 Docker 把模型掛好並透過 API 送出一份 workflow。
故事寫好、分好頁之後,每一頁都要一張插畫。這篇談的是在自己的機器上,把一句文字描述變成一張圖——也就是所謂的「文生圖」。和上一篇的語言模型一樣,重點不是某個雲端服務怎麼用,而是這類技術到底怎麼運作、怎麼在本地把它架起來。
技術前導:擴散模型怎麼生圖
直覺上你可能以為模型是「一筆一筆把圖畫出來」,實際上主流的擴散模型(diffusion model)做的事恰好相反:它從一張全是雜訊的圖開始,一步一步把雜訊「拿掉」,圖就慢慢從雜訊裡浮現出來。
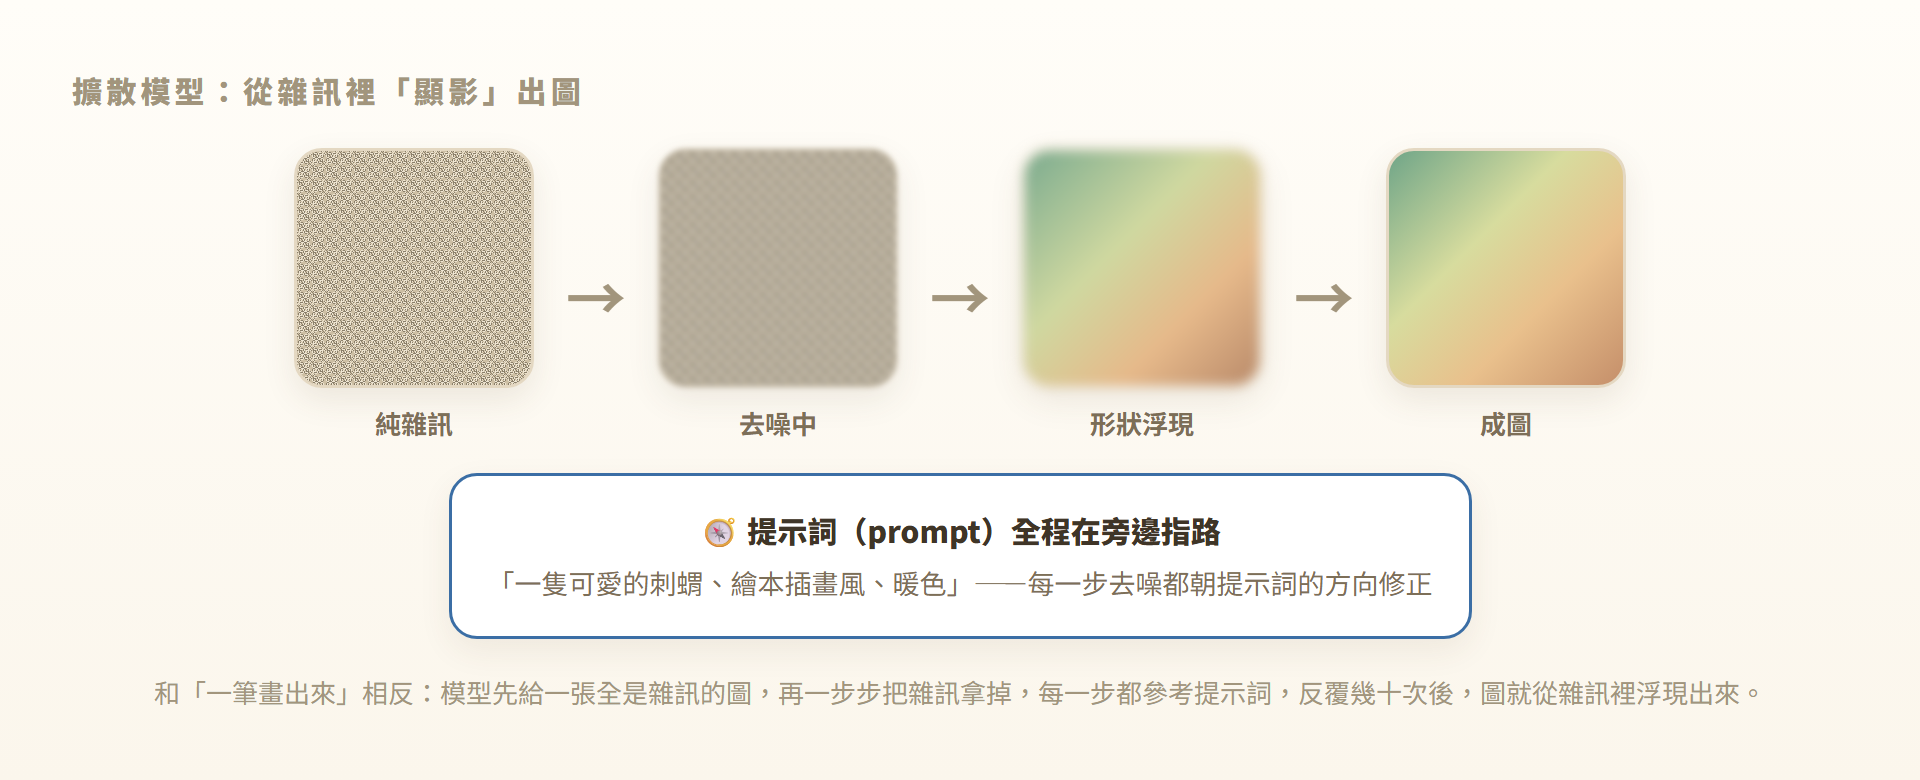
關鍵在於,去噪的每一步都被提示詞(prompt)牽著走。「一隻可愛的刺蝟、繪本插畫風、暖色」這句話不是畫完才比對,而是全程在旁邊指路,讓每一步都朝這個方向修正。所以提示詞寫得越具體,出來的圖越接近你要的樣子。反覆去噪的次數(steps)越多,通常越精緻,但也越花時間。
一張圖是好幾個模型疊出來的
「生一張圖」聽起來是一個模型的事,其實是好幾個部件疊起來的:
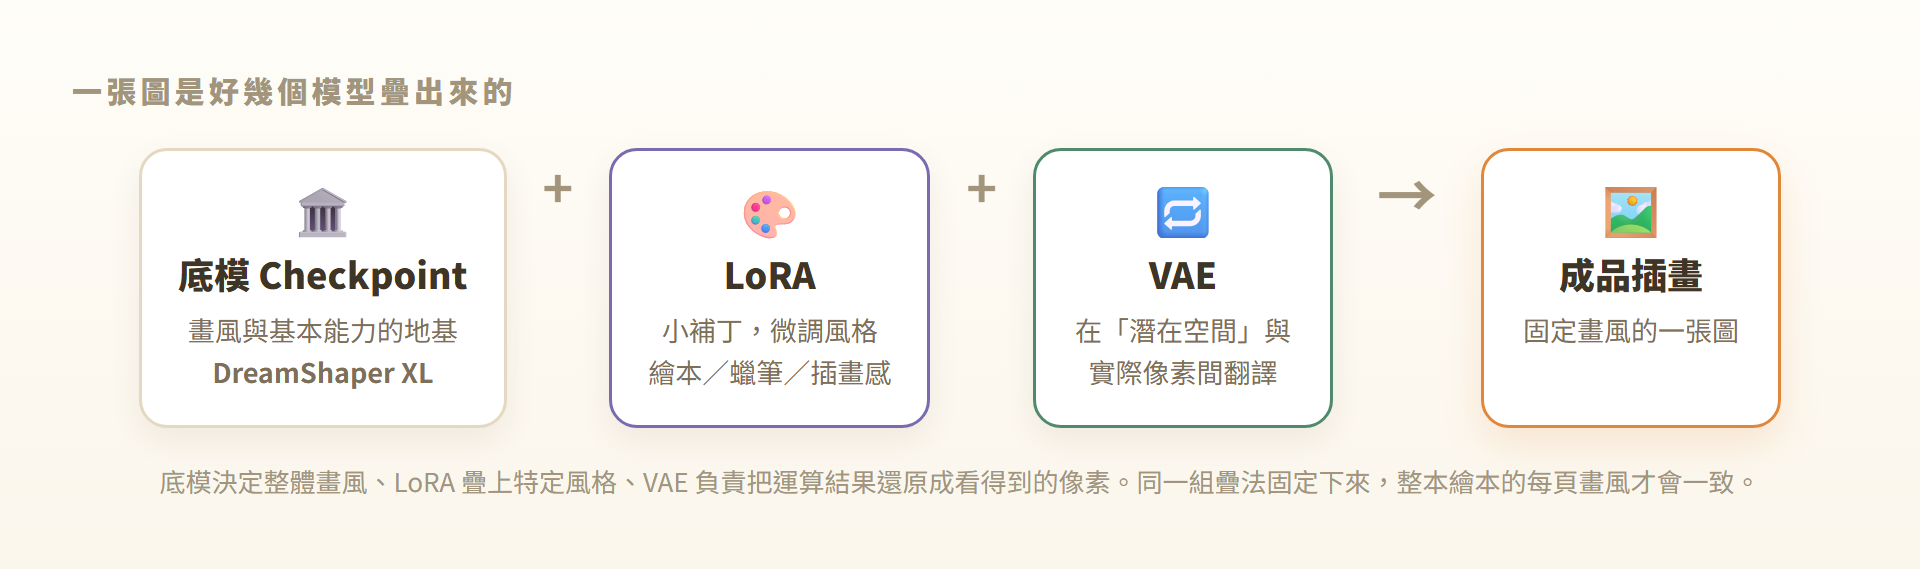
- **底模(checkpoint)**是地基,決定整體的畫風與基本能力。
- LoRA 是小補丁,疊在底模上做風格微調——繪本感、蠟筆感、某種插畫調性,都靠它。
- VAE 負責在模型運算的「潛在空間」和我們看得到的像素之間翻譯。
對繪本特別重要的是:同一組疊法要固定下來。整本書十幾頁,如果每頁的底模、LoRA 換來換去,畫風就會跳。把這組配方鎖住,是讓一本書看起來像「同一個人畫的」的前提。
為什麼用 ComfyUI
本地文生圖有不少工具,繪本這種要程式化、批次生成的場景,ComfyUI 很合適。它把整個生圖流程畫成一張「節點圖」(workflow):載入底模、疊 LoRA、吃提示詞、去噪、輸出,每個環節都是一個可調的節點。更重要的是,這張 workflow 可以匯出成 JSON,透過 API 送進去執行——這代表整個生圖流程能被程式自動化,而不是每次都要手動點。
容器化:把 ComfyUI 與模型掛好
模型檔很大,單一底模就好幾 GB,所以不會把它們打包進映像檔,而是放在主機上,用 volume 掛進容器。
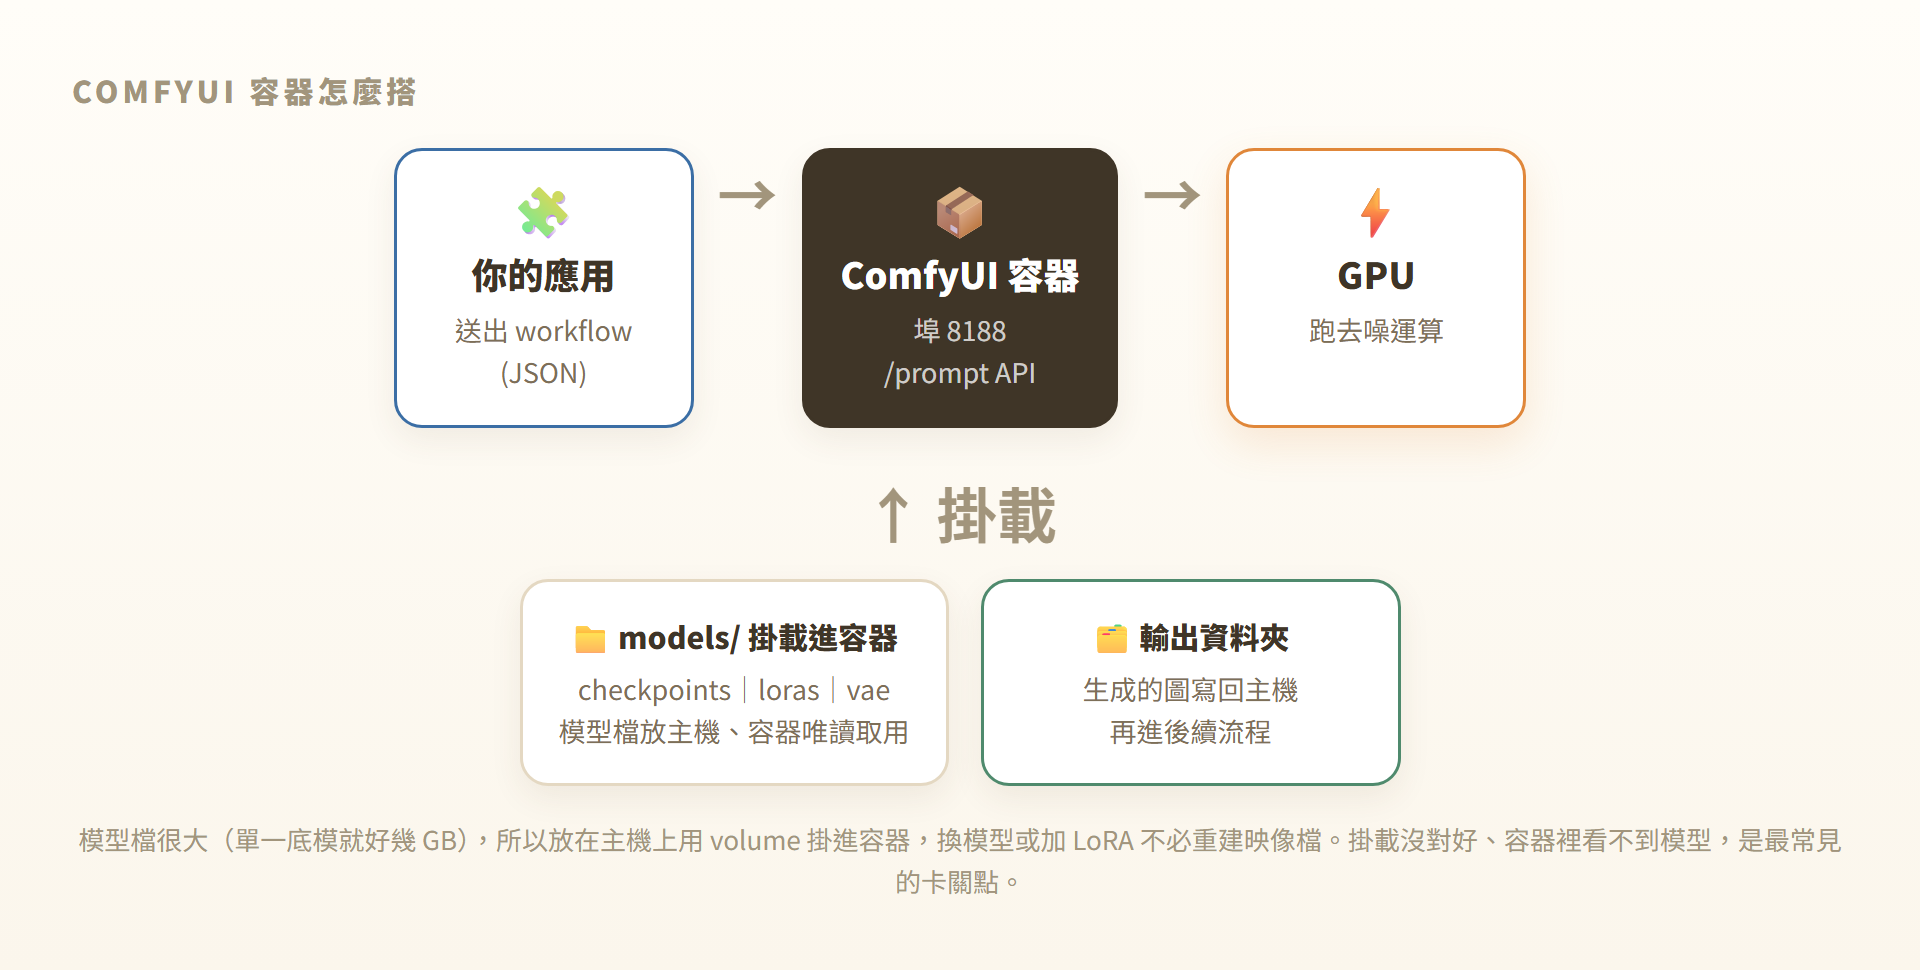
實務上最常卡關的,就是掛載沒對好:容器裡的 models/checkpoints、models/loras、models/vae 對應到主機上放模型的資料夾,只要路徑錯一個字,容器裡就看不到模型,生圖直接失敗。GPU 一樣要掛進容器,去噪的運算全靠它。生成的圖再寫回主機的輸出資料夾,交給後面的流程。
呼叫:送一份 workflow
服務起來之後,生圖的方式是:把那張 workflow(JSON)連同這次的提示詞、種子等參數,POST 到 ComfyUI 的 /prompt。它會把任務排進佇列,算完把圖寫到輸出資料夾。你的應用要做的,就是填好 workflow 樣板、送出、等結果。
因為每一頁都用同一份 workflow 樣板、只換提示詞,整本書的畫風才能穩定。也因為是走 API,才能讓程式一次把十幾頁排隊生完,而不用人一頁一頁盯著點。
最後:真正難的是「一致性」
把單張圖生出來其實不難,難的是讓同一個角色在每一頁長得一樣。純靠提示詞,模型每次都會畫出略有差異的「另一隻刺蝟」。要壓住這件事,得靠固定種子、參考圖、角色描述注入等手段,這也是把「能生圖」推進到「能做一本書」之間,最花工夫的一段。理解了底模+LoRA 的疊法與 workflow 的運作,你就有了處理這個問題的基礎。