技術筆記
把文字念成人聲:零樣本語音克隆 TTS
從 TTS 的運作原理談起,說明零樣本語音克隆為什麼只要幾秒參考音就能複製聲線,如何把一個 TTS 專案包成容器服務,以及中文合成實際會踩到的幾個坑。
繪本要「念」給孩子聽,所以每一句話都要變成語音。這篇談的是 TTS(Text-to-Speech,文字轉語音):機器怎麼把一句文字念出來,以及更進一步的零樣本語音克隆——只用幾秒鐘的參考音,就能用「那個聲音」念任何新句子。這是讓繪本角色有固定聲線的關鍵技術。
技術前導:文字怎麼變成人聲
早期的電子語音聽起來像機器人,是因為它把預錄的音節硬拼在一起。現代的 TTS 是即時「念」出來的,中間經過好幾道處理:
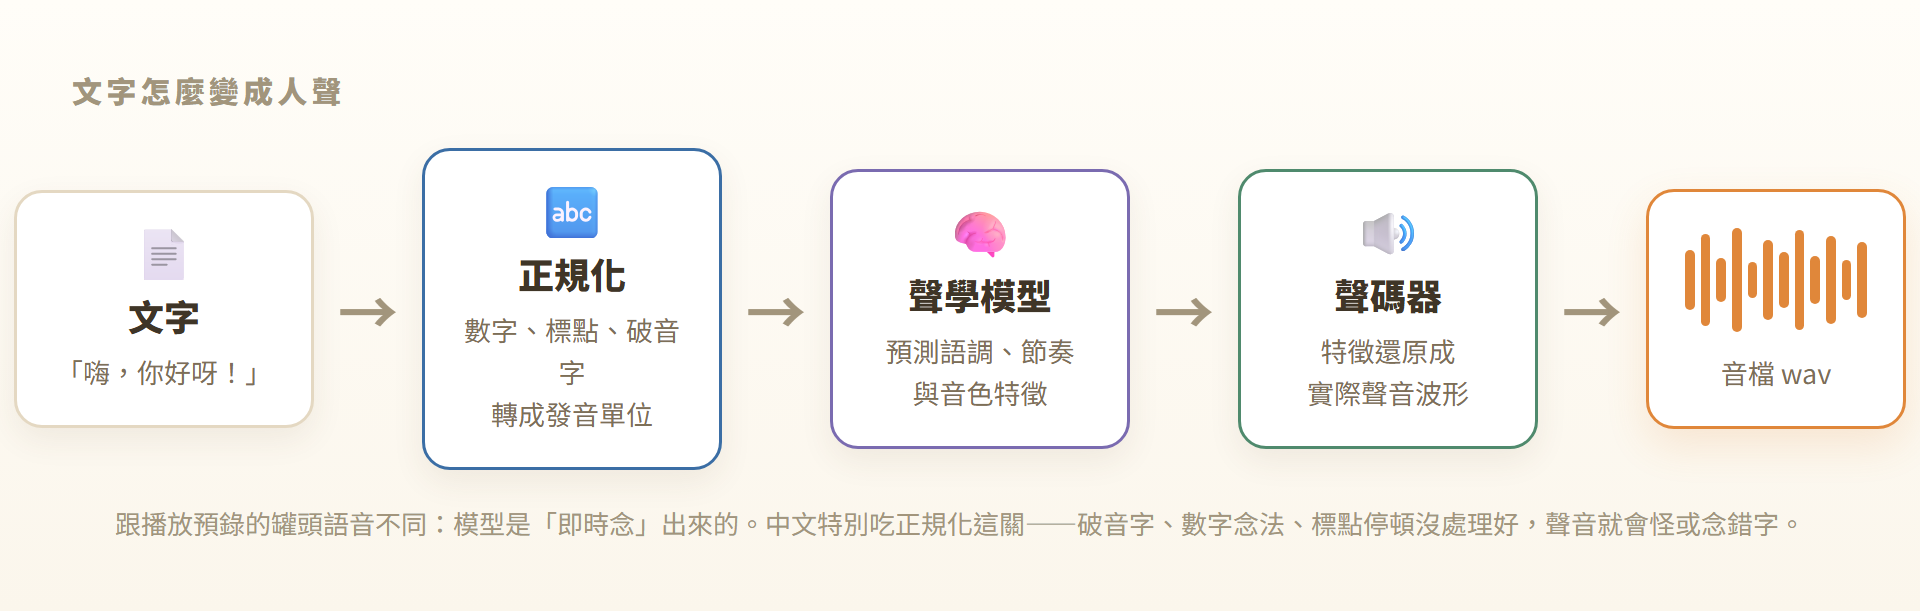
其中正規化這關對中文特別重要。「1000 元」要念「一千元」不是「一零零零元」、破音字要挑對讀音、標點決定停頓的長短——這些沒處理好,聲音就會念錯字或聽起來很怪。這也是中文 TTS 比英文難搞的地方:光是「這串文字實際上該怎麼念」,就有很多眉角。
零樣本語音克隆
傳統上要做出一個特定的聲音,得請人錄好幾個小時的語料,再花時間訓練一個專屬模型,成本很高。零樣本語音克隆把這件事整個翻過來:
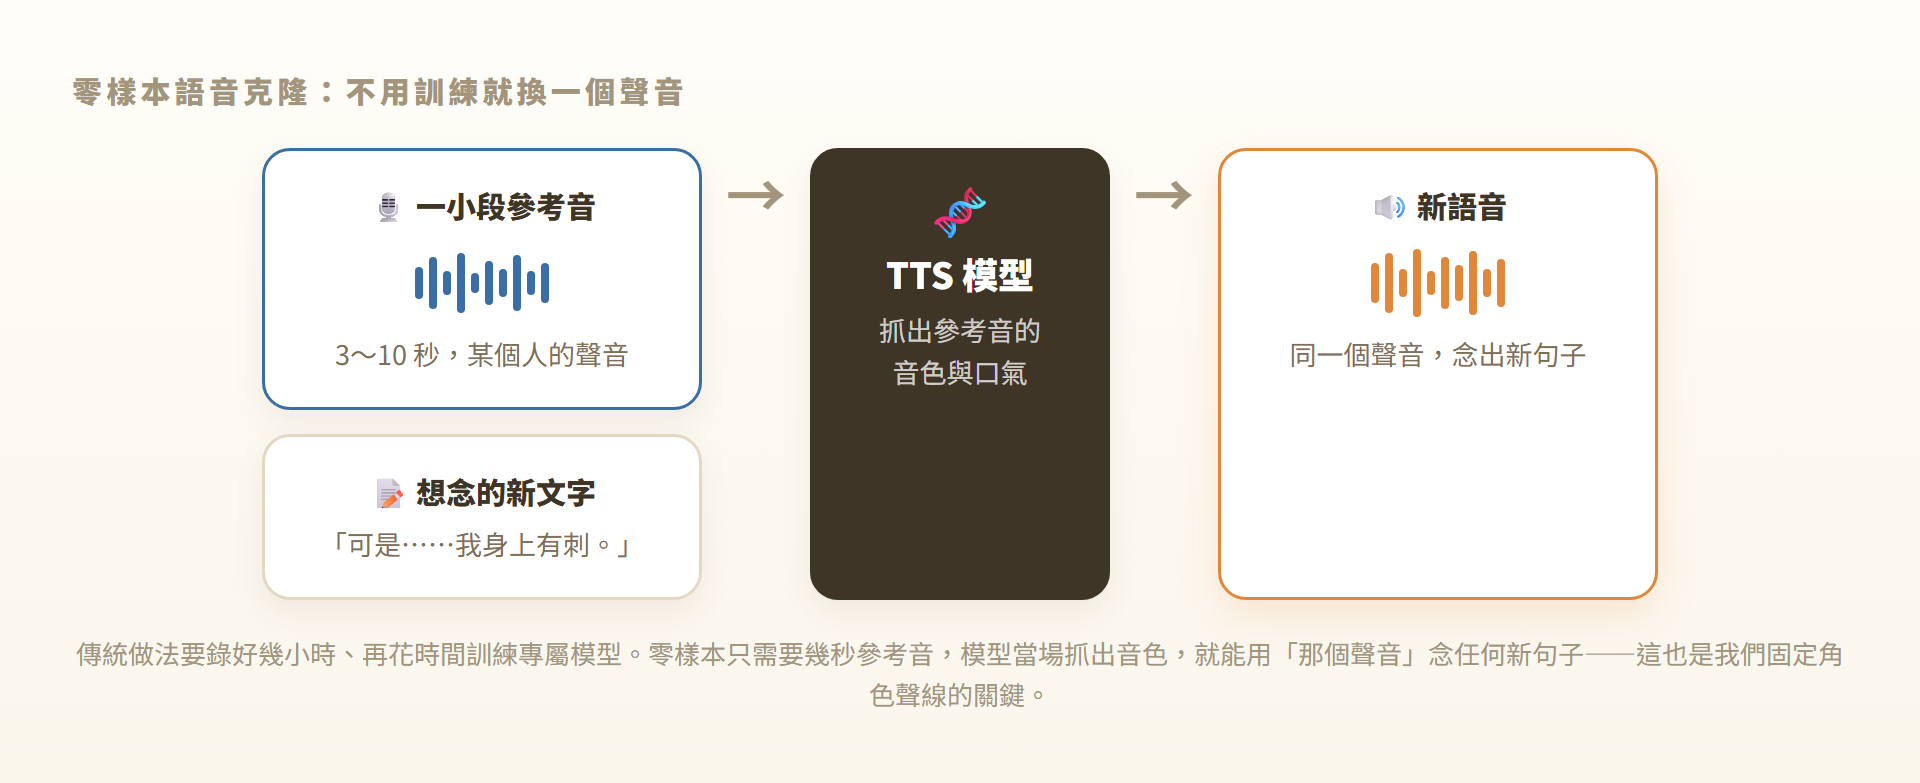
你只要給它一小段參考音(通常三到十秒)加上想念的新文字,模型會即時從參考音裡抓出音色、語氣的特徵,用「那個聲音」把新句子念出來——完全不需要事先訓練。對繪本來說,這意味著只要有一段乾淨的參考音,整個系列每一集都能用同一個聲線,角色的聲音就固定下來了。
挑一個模型
這類零樣本 TTS 有好幾個開源選擇,中文表現不錯的例如 CosyVoice 家族。挑模型時除了聲音自然度,還要看幾件事:對繁體中文的支援、參考音需要多長多乾淨、以及跑起來吃多少顯存。和文生圖類似,它一樣需要 GPU,而且生成時的顯存占用要和其他服務(例如同時在跑的生圖)錯開,不然會互相搶資源。
容器化:自己包一個 TTS 服務
這裡有個實務上的落差要先講清楚:**大多數開源 TTS 專案給你的是一段 Python 範例,不是一個服務。**你照著它跑,能在終端機生出一個 wav,但沒辦法被整套系統穩定呼叫。
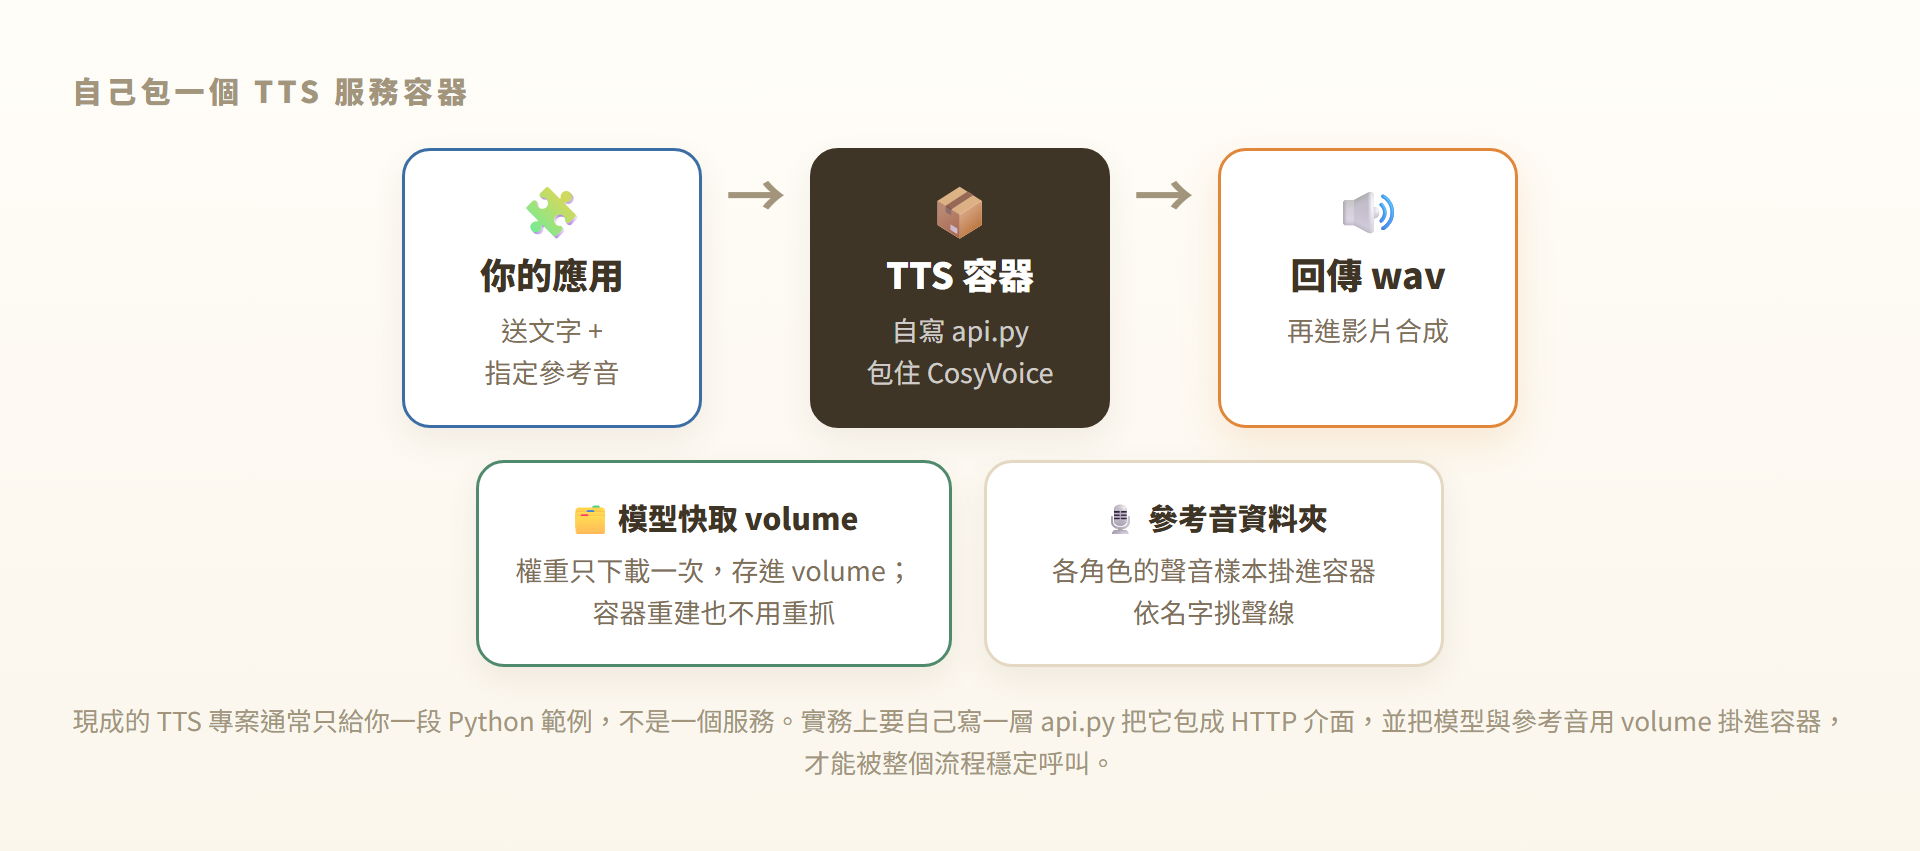
所以要自己補一層:寫一個 api.py 把模型包成 HTTP 介面,讓外部送文字進來、拿 wav 回去。模型權重用 volume 存起來,只下載一次;各角色的參考音也掛進容器,依名字挑聲線。把它容器化之後,TTS 才從「一段範例程式」變成「流程裡一個可靠的環節」。
呼叫與踩坑
介面通了,真正的功夫才開始。中文合成實際會遇到的坑,我們大多都撞過:
- 斷句要自己切:一次丟一長段進去,模型容易念到後面走音或吃字。把長句依標點切成合適的小段,穩定度會明顯提升。
- 標點會影響發音:某些符號會被模型當成要念的內容,或造成奇怪的停頓,送進去之前要先清理過。
- 開頭的靜音:生成出來的音檔開頭常帶一小段空白,串成影片時每句前面都頓一下,得在後處理把它修掉。
- 太短的句子不穩:只有兩三個字的句子,模型有時會念得含糊,必要時要重試或和前後句合併。
這些都不是模型「壞掉」,而是把一個研究用的模型推向實際生產時,必然要補的工。把這層補起來,繪本裡的每一句話才能穩定地、用對的聲音念出來。